Chinesische KI-Modelle Wettbewerb: GLM-5.2 setzt Preise zurück
Wie ein günstiges Modell aus China das Kräfteverhältnis zu OpenAI und Anthropic verschiebt und was das für die Tool-Auswahl bedeutet.

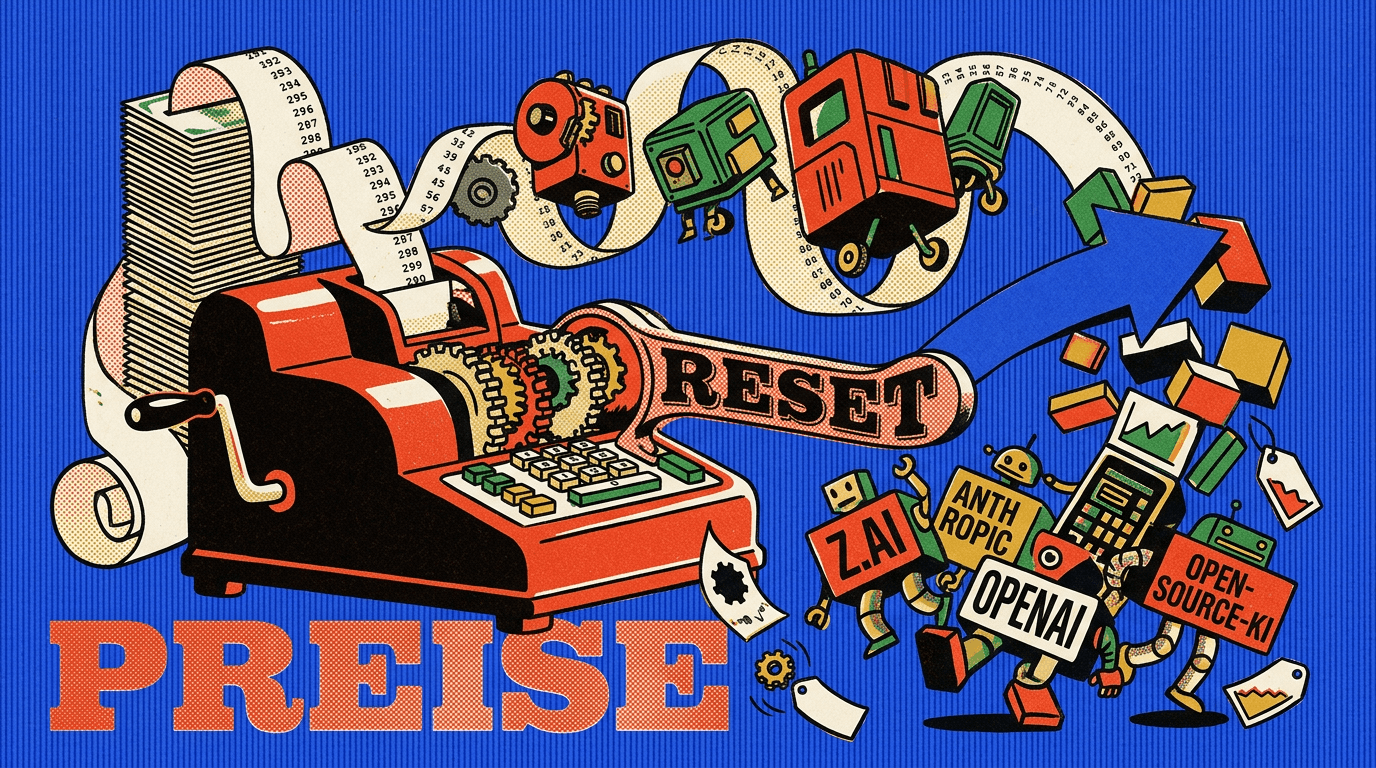
Der chinesische KI-Modelle Wettbewerb hat mit GLM-5.2 eine neue Stufe erreicht: Das Open-Source-Modell des Anbieters Z.ai konkurriert laut Reuters vom 2. Juli 2026 direkt mit Modellen von Anthropic und OpenAI, und zwar zu deutlich niedrigeren Kosten. Für Unternehmen im DACH-Raum verschiebt das nicht die Frage, ob KI etwas taugt, sondern was eine Anfrage kosten darf.
Der eigentliche Punkt liegt im Preis, nicht in einem angeblichen Technologiesprung. Wenn ein Modell vergleichbare Ergebnisse zu einem Bruchteil der Kosten liefert, ändert das die Kalkulation jedes produktiven Einsatzes. Genau darauf sollten Sie schauen, bevor Sie Schlagzeilen über einen „Machtwechsel" für bare Münze nehmen.
Was ist an GLM-5.2 wirklich neu?
Neu ist die Kombination aus offener Verfügbarkeit und niedrigem Preis bei zugleich konkurrenzfähiger Leistung. Euronews berichtete am 3. Juli 2026, dass Z.ai sein Modell als Open-Source-Alternative positioniert, die mit Claude und GPT-5.5 mithalten soll. Das ist ein Detailfortschritt im Preis, kein Bruch in den Fähigkeiten.
Zur Einordnung gehört das Timing. Laut Euronews brachte Z.ai das Modell einen Tag nach einem US-Exportstopp für Anthropic-Modelle auf den Markt. Diese Beschränkungen wurden am 30. Juni wieder aufgehoben. Solche Zusammenhänge lesen sich in Ankündigungen gern als strategischer Coup, sind im Kern aber gewöhnliche Marktmechanik.
Was bislang unabhängig belegt ist, bleibt schmal. Reuters und Euronews beschreiben das Modell als günstig und konkurrenzfähig. Belastbare, unabhängig geprüfte Benchmarks mit offengelegter Testmethodik liegen in den vorliegenden Quellen nicht vor. Behandeln Sie die Fähigkeitsversprechen daher als Anbieterangabe, bis Fachredaktionen oder Forschungsgruppen nachgemessen haben.
Verschiebt sich das Kräfteverhältnis zu OpenAI und Anthropic?
Kurzfristig verschiebt sich vor allem der Preisdruck, nicht die technologische Führung. Ein günstiges, offenes Modell zwingt die etablierten US-Anbieter, ihre Preise und ihre Argumente zu überdenken. Das ist der bekannte Reifeweg solcher Themen: erst der Hype um den „Aufholer", dann die nüchterne Frage, was im Dauerbetrieb trägt.
Der wiederkehrende Fehler in der Berichterstattung ist die Gleichsetzung von „aufholen" mit „überholen". Ein Modell kann in einzelnen Aufgaben mithalten und in anderen zurückliegen. Ohne breite, unabhängige Vergleiche über verschiedene Aufgabentypen bleibt jede pauschale Rangfolge Spekulation.
Für die Praxis zählt ohnehin weniger die Rangliste als die Passung. Ein teureres Modell kann sich rechnen, wenn es Ihren speziellen Fall zuverlässiger löst. Ein günstiges lohnt sich dort, wo Volumen und Standardaufgaben dominieren. Wer diese Unterscheidung sucht, findet in der Frage, wann kleine, offene Modelle den großen überlegen sind, einen brauchbaren Ausgangspunkt.
Wenn Sie mehrere Modelle strukturiert gegeneinander testen und die für Ihren Zweck passende Option auswählen wollen, kann ein praxisorientierter Vergleich der wichtigsten KI-Tools für Führungskräfte die Auswahl beschleunigen. Sinnvoll ist das vor allem, wenn in Ihrem Haus noch keine klare Entscheidungslogik existiert; wer bereits ein eingespieltes Auswahlverfahren hat, braucht ihn nicht.
Was bedeutet das für die Tool-Auswahl in DACH-Unternehmen?
Für Unternehmen im DACH-Raum verschiebt sich die Auswahl weg vom reinen Fähigkeitsvergleich hin zu Kosten, Betriebsort und Compliance. Ein günstiges chinesisches Open-Source-Modell ist technisch attraktiv, wirft aber Fragen auf, die bei US-Modellen anders liegen: Wo laufen Ihre Daten, wer haftet, welche Herkunftsangaben lassen sich prüfen.
Aus meiner Beratungspraxis sehe ich ein Muster: Firmen entscheiden nach dem Preis pro Token, nicht nach den Gesamtkosten inklusive Integration, Prüfung und Betrieb. Ein paar Punkte, die vor jeder Modellwahl geklärt gehören:
- Datenschutz und Betriebsort: Läuft das Modell lokal, in der EU oder auf Servern außerhalb, und was heißt das für personenbezogene Daten?
- Anwendungsfall statt Ranking: Testen Sie an Ihren eigenen Aufgaben, nicht am beworbenen Benchmark. Ein Bestwert ist ein Hinweis, kein Beweis.
- Gesamtkosten: Rechnen Sie Integration, Wartung und menschliche Kontrolle mit, nicht nur den Preis pro Anfrage.
- Regulatorik: Klären Sie früh, in welche Risikoklasse des EU AI Act Ihre Anwendung fällt.
Wer die regulatorische Seite unterschätzt, zahlt später drauf. Der Unterschied zwischen den beiden Regelsystemen wird im Vergleich von EU AI Act und US-Regulierung deutlich. Bei einem offenen Modell aus China kommt hinzu, dass Sie den Betrieb weitgehend selbst verantworten, was Kontrolle bringt, aber auch Pflichten.
Sollten Sie jetzt wechseln?
Nein, ein Wechsel allein wegen einer Ankündigung wäre voreilig. Sinnvoll ist ein kontrollierter Test an einem konkreten, häufig vorkommenden Anwendungsfall, gemessen an Qualität und Gesamtkosten. Erst wenn ein günstigeres Modell Ihren Fall verlässlich löst, wird der Wechsel zur begründeten Entscheidung.
Behalten Sie dabei die Sicherheitsfrage im Blick. Ein neues Modell, egal woher, gehört vor dem produktiven Einsatz geprüft. Welche Schritte dabei zählen, fasst der Beitrag zu KI-Sicherheit im Unternehmen zusammen.
Zurück zur Ausgangsfrage: Setzt der chinesische KI-Modelle Wettbewerb das Rennen zurück? Beim Preis ja, spürbar. Bei der Führung in den Fähigkeiten fehlt bislang der unabhängige Beleg, dass jemand die anderen überholt hat. Für Ihr Unternehmen entscheidet nicht, welche Fahne über dem Modell weht, sondern ob es Ihren Fall zu tragbaren Kosten und unter Ihren Compliance-Vorgaben löst. Der nächste Schritt ist ein Test an genau diesem Fall, nicht die nächste Schlagzeile.
Häufige Fragen
Lohnt sich ein Wechsel zu GLM-5.2 allein wegen des Preises?
Der Preis ist das stärkste Argument, aber nicht das einzige Kriterium. Prüfen Sie, ob die Leistung für Ihren konkreten Anwendungsfall reicht, und rechnen Sie neben den Anfragekosten auch Integration, Wartung und Support ein. Solange unabhängige Benchmarks fehlen, sollten Sie mit einem begrenzten Pilotprojekt testen, bevor Sie produktive Prozesse umstellen.
Wie kann ich die versprochene Leistung von GLM-5.2 selbst überprüfen?
Verlassen Sie sich nicht auf Anbieterangaben. Testen Sie das Modell mit Ihren eigenen, realistischen Aufgaben und vergleichen Sie die Ergebnisse direkt mit Claude oder GPT-5.5. Achten Sie zusätzlich auf unabhängig geprüfte Benchmarks mit offengelegter Testmethodik von Fachredaktionen oder Forschungsgruppen, sobald diese vorliegen. Bis dahin gilt jedes Fähigkeitsversprechen als unbestätigt.
Was bedeutet Open Source hier konkret für Unternehmen im DACH-Raum?
Offene Verfügbarkeit kann heißen, dass Sie das Modell selbst hosten, anpassen und feintunen dürfen, was Kostenkontrolle und Datenschutz erleichtert. Prüfen Sie aber genau die Lizenzbedingungen: „Open Source" wird nicht immer einheitlich verwendet. Klären Sie, ob kommerzielle Nutzung, Weitergabe und eigenes Training erlaubt sind, bevor Sie darauf aufbauen.
Gibt es rechtliche oder Compliance-Risiken beim Einsatz eines chinesischen KI-Modells?
Ja, das sollten Sie vorab klären. Relevant sind Datenschutz nach DSGVO, der EU AI Act sowie mögliche Export- und Nutzungsbeschränkungen, die sich, wie im Artikel erwähnt, kurzfristig ändern können. Klären Sie außerdem, wo Daten verarbeitet werden und ob Selbst-Hosting nötig ist. Beziehen Sie Ihre Rechts- und Sicherheitsabteilung früh ein.
Verdrängt der Preiskampf jetzt Anbieter wie OpenAI und Anthropic?
Der Artikel spricht bewusst nicht von einem „Machtwechsel". Ein günstiges, konkurrenzfähiges Open-Source-Modell erhöht den Preisdruck, aber etablierte Anbieter punkten weiter mit Ökosystem, Support und geprüfter Zuverlässigkeit. Realistisch ist eine breitere Auswahl mit sinkenden Preisen, nicht die schnelle Verdrängung eines Anbieters. Behandeln Sie Schlagzeilen über einen Umbruch mit Skepsis.
Wie starte ich sinnvoll, ohne mich auf einen Anbieter festzulegen?
Bauen Sie Ihre Anwendung so, dass das Modell austauschbar bleibt, etwa über eine Abstraktionsschicht. So können Sie GLM-5.2, Claude und GPT parallel an denselben Aufgaben messen und nach Kosten und Qualität entscheiden. Beginnen Sie mit einem klar abgegrenzten Anwendungsfall, definieren Sie Erfolgskriterien und skalieren Sie erst nach belastbaren Ergebnissen.
Fügen Sie KI-Amigo in Google als bevorzugte Quelle hinzu, um unsere Artikel häufiger zu sehen.
Weiterlesen
Mehr aus Tools & Modelle →
Aleph Alpha Kolibri: Neues Open-Source-Modell für den eigenen Server
Aleph Alpha stellt das Sprachmodell Kolibri unter eine offene Lizenz. Das System richtet sich an Behörden und Industrieunternehmen, die interne Daten auf eigenen Servern verarbeiten wollen. Belastbare Leistungstests stehen noch aus.
Project Suncatcher: Erste KI-Rechenzentren im Weltall stoßen auf Transportgrenzen
Google hat einen Satelliten mit vier KI-Chips in den Erdorbit gebracht, um orbitale Recheninfrastruktur zu testen. Das Projekt macht die Energieprobleme der Branche sichtbar, ändert jedoch nichts an laufenden IT-Strategien.
Black Forest Labs veröffentlicht Flux 3 Image für schrittweise Bildbearbeitung
Black Forest Labs hat das Modell Flux 3 Image veröffentlicht. Es verlagert den Schwerpunkt bei der KI-Bildgenerierung von der Motiverzeugung auf die mehrstufige Bearbeitung bestehender Entwürfe.
Sprachagenten ab 100 Millisekunden: Microsoft baut sein eigenes Audio-Ökosystem auf
Microsoft erweitert sein Angebot um drei Modelle für Echtzeit-Transkription und Sprachausgabe. Entwickler erhalten damit fertige Bausteine für interaktive Sprachanwendungen und sparen sich den Aufbau eigener Systeme.
Gemini 4 Argon: Googles neues KI-Modell startet mit internen Zweifeln an der Programmierleistung
Google beschränkt den Zugang zu seinem neuen KI-Spitzenmodell vorerst auf ausgewählte Sicherheitsexperten. Während der Konzern mit starken Benchmark-Ergebnissen wirbt, wecken interne Berichte über schwache Programmierleistungen Zweifel an der Praxistauglichkeit.
Claude Sonnet 5.5: Neues KI-Modell rechnet schneller und drückt die Betriebskosten
Anthropic veröffentlicht mit Claude Sonnet 5.5 eine neue Version seines Mittelklassemodells. Es löst Aufgaben schneller als der Vorgänger und senkt die Kosten der Textverarbeitung deutlich.