Aleph Alpha Kolibri: Was Unternehmen vor dem Eigenbetrieb prüfen sollten
Offene Gewichte ermöglichen mehr Kontrolle. Entscheidend sind Hardwarebedarf, Kontextgrenzen, Datenflüsse und die Qualität bei den eigenen Aufgaben.

Aleph Alpha veröffentlicht mit Kolibri ein Open-Weight-Sprachmodell für den Betrieb auf eigener Infrastruktur. Die offizielle Modellkarte nennt 78,1 Milliarden ParameterDie internen Gewichtungen eines KI-Modells, die beim Training angepasst werden. Ihre Anzahl gilt als grober Maßstab für die Komplexität des Systems. insgesamt und 3,46 Milliarden aktive Parameter je TokenTexteinheit, die ein Sprachmodell verarbeitet. Sie kann einem Wort, einem Wortteil oder einem Zeichen entsprechen.. Die Gewichte stehen unter Apache 2.0. Für Behörden und Unternehmen eröffnet das zusätzliche Kontrolle über den Betrieb; die konkrete Installation muss trotzdem auf Sicherheit, Qualität und Kosten geprüft werden.
Die aktive Modellgröße beschreibt nicht den gesamten Speicherbedarf
Kolibri nutzt eine Mixture-of-ExpertsModellarchitektur mit mehreren Teilnetzwerken. Pro Token werden ausgewählte Teile aktiviert; die gesamte Modellgröße kann deutlich größer als der aktive Teil sein.-Architektur: Je verarbeitetem Token arbeitet nur ein Teil der Modellparameter. Die übrigen Gewichte müssen für die Berechnung dennoch verfügbar sein. Eine kleine aktive Parameterzahl bedeutet deshalb nicht, dass das gesamte Modell auf entsprechend kleiner Hardware läuft.
Die Modellkarte nennt für die FP8-Gewichte ungefähr 78 Gigabyte und als Hardwarebeispiele zwei A100-GPUs mit jeweils 80 Gigabyte oder eine H200. Das ist keine Kapazitätszusage für beliebig lange Eingaben oder viele gleichzeitige Nutzer. Zusätzlich fallen unter anderem Speicher für den Kontext und Laufzeitkomponenten an. Für die Bereitstellung beschreibt der Hersteller ein Inferenzpaket mit vLLM-Plugin.
Eine Million Token sind eine extrapolierte Obergrenze
Die Dokumentation unterscheidet 262.144 Token nativen Kontext von einer auf 1.048.576 Token extrapolierten Länge. Für komplexe Aufgaben empfiehlt sie den nativen Bereich. Die größere Angabe ist daher keine Garantie, dass jede Information aus einem sehr langen Dokument zuverlässig gefunden oder korrekt verknüpft wird.
Ein sinnvoller Test enthält bekannte Antworten an unterschiedlichen Stellen langer Dokumente, widersprüchliche Fassungen und gezielte Rückfragen. So zeigt sich, ob das System die gesuchten Belege tatsächlich verwendet. Ein bloßer erfolgreicher Upload sagt darüber wenig aus.
Hersteller-Benchmarks sind vorhanden und müssen eingeordnet werden
Aleph Alphas Vorstellung enthält Leistungsangaben und Benchmark-Tabellen. Sie sind Herstellerergebnisse und kein unabhängiger Nachweis für die Eignung in jeder Verwaltungs- oder Industrieaufgabe. Entwicklung in Deutschland sowie Training in Deutschland und Finnland sind ebenfalls Angaben des Unternehmens.
Für die Beschaffung sollten dieselben repräsentativen Aufgaben mit mehreren geeigneten Modellen geprüft werden. Dazu gehören fachliche Qualität, Quellenbezug, Reaktionszeit, notwendige Nacharbeit und Gesamtkosten. Ein pauschales Versprechen fehlerfreier Antworten wäre für generative Sprachmodelle kein belastbares Auswahlkriterium.
Eigenbetrieb verlangt klare Betriebsverantwortung
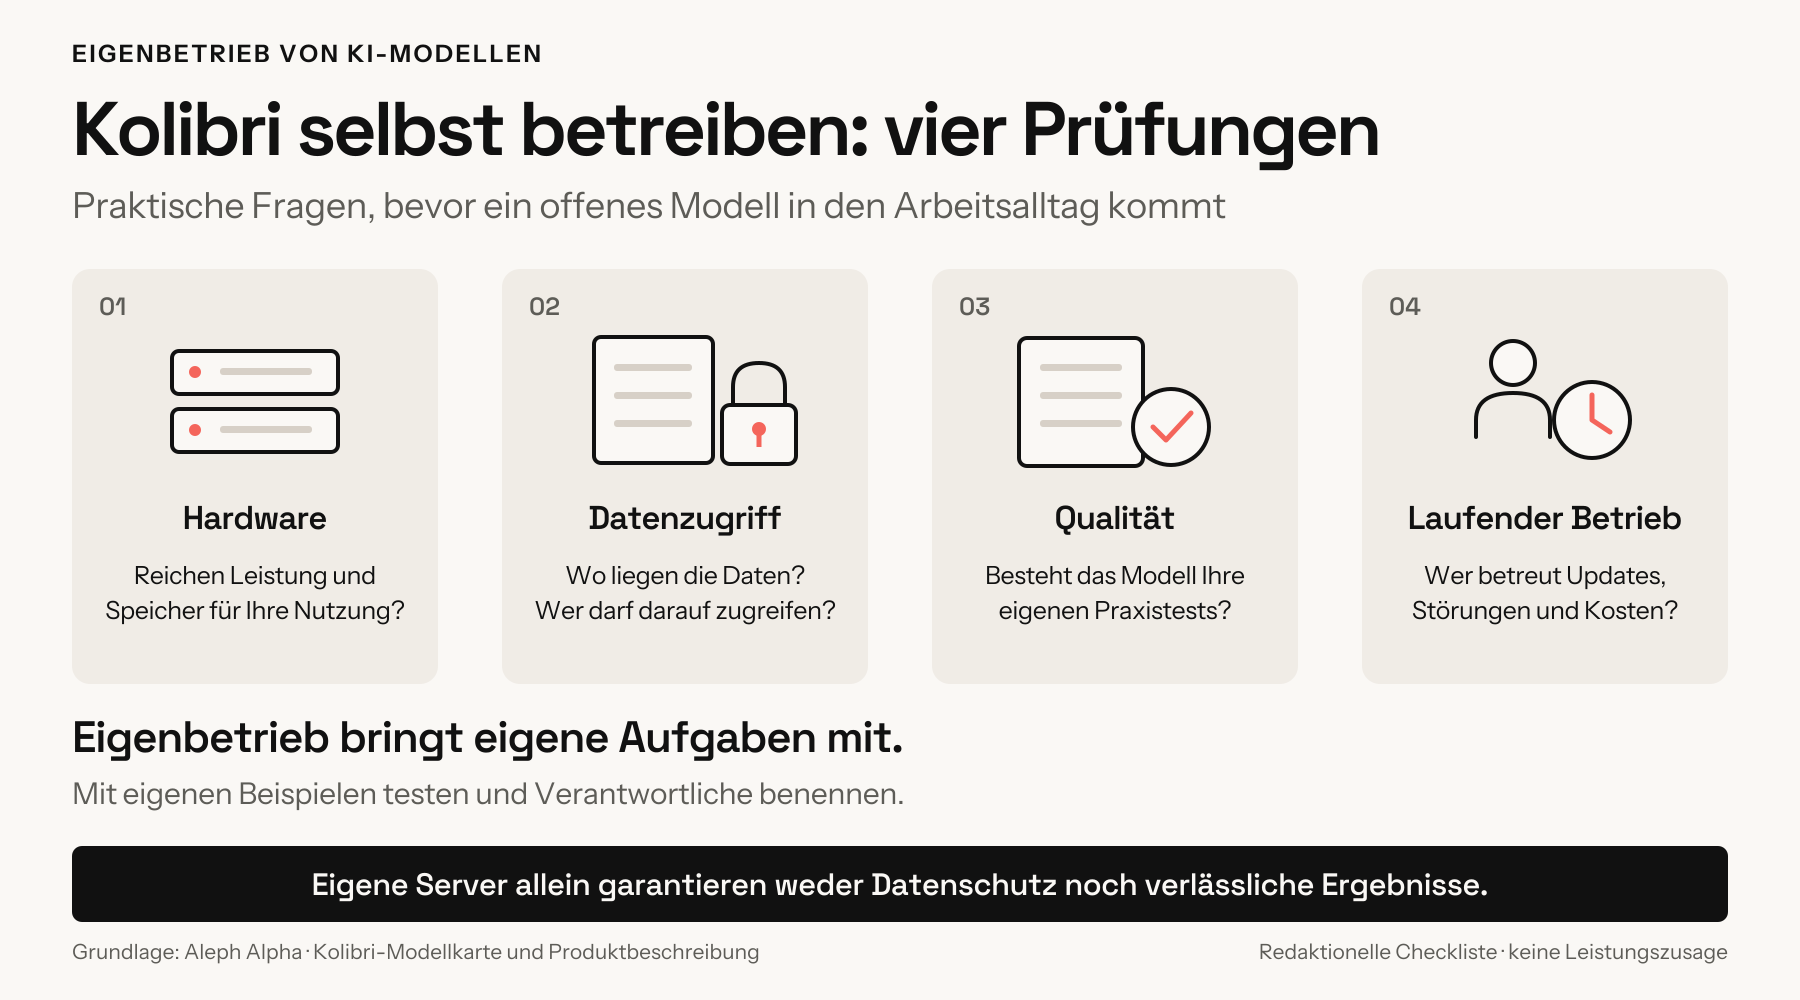
Redaktionelle Checkliste für den Eigenbetrieb. Eigene Server allein garantieren weder Datenschutz noch verlässliche Ergebnisse.
Ob Daten die eigene Umgebung verlassen, hängt von der gesamten Anwendung ab: eingebundene Dienste, Protokollierung, Telemetrie und Zugriffsrechte müssen mitgeprüft werden. Die Veröffentlichung der Gewichte allein verhindert keinen Datenabfluss.
Vor einem Pilotbetrieb sollten Verantwortliche für Updates, Sicherheitsprüfung, Modellversionen und Support benannt werden. Im Rahmen der AI Governance lassen sich außerdem akzeptable Fehlerraten und Aufgaben festlegen, bei denen eine menschliche Freigabe nötig bleibt. Anschließend kann ein begrenzter Test mit freigegebenen Daten zeigen, ob Qualität und Betriebsaufwand zu den eigenen Anforderungen passen.
Was gibt bei der Entscheidung für ein lokal betriebenes KI-Modell wie Kolibri den Ausschlag?
Ergebnisse sehen Sie nach Ihrer Stimme.
Häufige Fragen
Was bedeutet die offene Apache-2.0-Lizenz bei Kolibri konkret?
Die Gewichte dürfen unter den Bedingungen der Apache-2.0-Lizenz genutzt werden. Für eine konkrete Installation sollten auch die Bedingungen aller zusätzlichen Komponenten geprüft werden. Hardware, Einrichtung, Wartung und fachliche Kontrolle verursachen unabhängig davon Aufwand.
Schützt der Betrieb im eigenen Rechenzentrum automatisch vor Datenschutzproblemen?
Nein. Datenflüsse hängen von der gesamten Anwendung ab, etwa von angeschlossenen Diensten, Protokollen und Telemetrie. Zugriffsrechte, rechtliche Grundlage, Sicherheitsmaßnahmen und Verantwortlichkeiten müssen auch beim Eigenbetrieb geprüft werden.
Welche Hardware benötigen Behörden für Kolibri?
Die Modellkarte enthält Hardwarebeispiele. Sie ersetzen keine Dimensionierung für den eigenen Einsatz: Kontextlänge, parallele Anfragen, Zahlenformat und Laufzeitkomponenten beeinflussen den Bedarf. Die gesamte Installation benötigt mehr als nur den Speicher für aktive Parameter.
Wie lässt sich Kolibri mit anderen Sprachmodellen vergleichen?
Hersteller-Benchmarks sind veröffentlicht. Für eine Beschaffung sollten zusätzlich gleiche, repräsentative Aufgaben mit mehreren Modellen getestet werden. Wichtig sind fachliche Richtigkeit, Quellenbezug, Formatvorgaben, Reaktionszeit und notwendige Nacharbeit.
Wie startet eine Organisation mit dem Betrieb von Kolibri?
Zuerst sollten Aufgabe, freigegebene Testdaten, Qualitätskriterien und Betriebsverantwortung feststehen. Dann folgt eine begrenzte Installation nach aktueller Herstellerdokumentation. Vor dem Produktiveinsatz gehören Lasttests, Rechtekonzept, Fehlerbehandlung und ein Update-Verfahren dazu.
Lohnt sich Kolibri trotz des zusätzlichen Betriebsaufwands?
Das hängt von Aufgaben, Schutzbedarf, Auslastung und vorhandener Infrastruktur ab. In die Rechnung gehören Hardware, Energie, Wartung, Fachpersonal und Nachprüfung der Ergebnisse. Ein Pilot mit messbaren Qualitäts- und Kostenkriterien liefert die Entscheidungsgrundlage.
Fügen Sie KI-Amigo in Google als bevorzugte Quelle hinzu, um unsere Artikel häufiger zu sehen.
Weiterlesen
Mehr aus Tools & Modelle →
Gemini 4 Neon schreibt fast doppelt so schnell wie Googles Carbon
Google hat am 18. November 2026 Gemini 4 Neon vorgestellt. Es erreicht im Test die Leistung von Carbon, schreibt fast doppelt so schnell und kostet ab Dezember 2026 pro Token ein Viertel weniger. Warum jetzt der richtige Moment ist, die Modellwahl zu prüfen.
Gemini überarbeitet ganze Präsentationen in Google Slides, zunächst nur auf Englisch
Gemini in Google Slides passt Stil und Inhalte einer ganzen Präsentation mit einer Anweisung an. Die Funktion versteht zum Start nur Englisch. Der Ratgeber zeigt die Schritte, Vorlagen für Anweisungen, die Grenzen und den Vergleich mit Copilot in PowerPoint und Claude in Google Slides.
Gemini 4 Argon ist allgemein verfügbar: Das müssen Unternehmen zu Kosten und Einsatz wissen
Google bietet sein Spitzenmodell Gemini 4 Argon seit 13. Oktober 2026 allgemein an. Nach dem Einführungspreis bis 30. November 2026 kosten Token doppelt so viel. Im unabhängigen Vals Index liegt Argon nicht mehr vorn. Was Unternehmen zu Kosten, Leistung und EU-Betrieb wissen sollten.
Apple KI in Pages, Keynote, Numbers: Externe Agenten erhalten Zugriff auf Dokumente
Apple bringt im November 2026 einen KI-Assistenten als Beta in Pages, Keynote und Numbers, zunächst für Abonnenten von Apple Creator Studio. Über das Model Context Protocol können externe KI-Agenten auf die Programme zugreifen. Wie Nutzer diese Zugriffe steuern, hat Apple noch nicht erklärt.
GPT-6.1 Terra: OpenAI senkt die Kosten für KI-Agenten
OpenAI hat GPT-6.1 Terra für ChatGPT Work, Codex und die API veröffentlicht. Das Modell eignet sich für Hintergrundaufgaben und KI-Agenten, bei denen der Preis pro Token mehr zählt als die maximale Leistung.
Canva Craft veröffentlicht: Neues Bildmodell trennt Planung und Ausführung
Canva veröffentlicht mit Canva Craft ein eigenes KI-Bildmodell. Eine zweistufige Architektur plant das Layout vor dem Rendern und soll gezielte Änderungen ermöglichen.