Meta verschiebt die neuen Geschäftsbedingungen: Das sollten Unternehmen jetzt prüfen
Meta begrenzt den Zweck auf Werbe- und Geschäftsprodukte, eine Zusage zur robots.txt, der Steuerdatei für Crawler, steht aber nicht im Vertragstext. Offen ist, ob eine Sperre gegen die vertragliche Erlaubnis hilft.

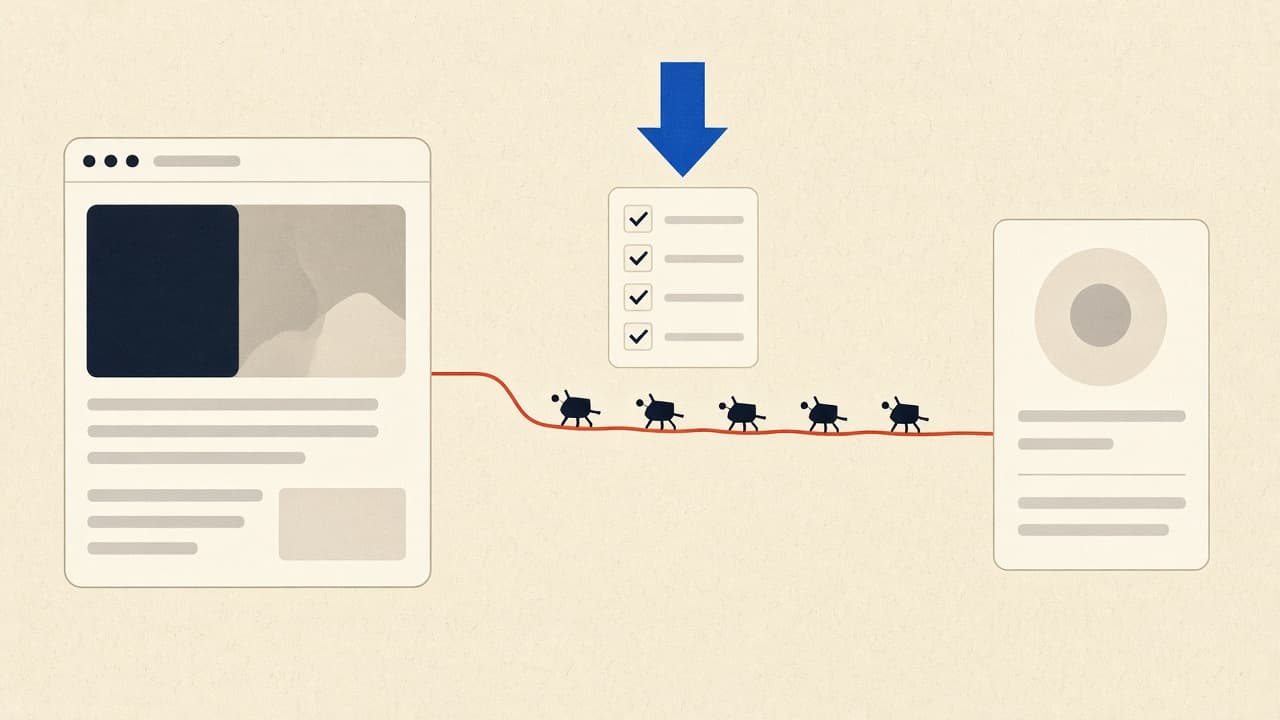
Soll Meta einen Schlüssel zu Ihrer Website bekommen? Wer Facebook, Instagram, WhatsApp oder Threads geschäftlich nutzt, soll Meta laut den neuen Geschäftsbedingungen erlauben, die eigenen Websites automatisch auszulesen. Mit Ihrer Zustimmung geben Sie Meta einen Schlüssel zu Ihrer Website. Ihre robots.txtTextdatei im Hauptverzeichnis einer Website, die festlegt, welche Crawler welche Bereiche abrufen sollen. Technisch bindet sie Crawler nicht, in der EU kann eine Sperre aber als maschinenlesbarer Vorbehalt gegen Text- und Data-Mining wirken., die Steuerdatei für CrawlerEin Programm, das Websites automatisch aufruft und deren Inhalte ausliest, etwa für Suchmaschinen, Linkvorschauen oder das Training von KI-Modellen. Andere Bezeichnungen sind Bot, Spider oder Scraper., also automatische Leseprogramme, ist dagegen ein Schild an der Tür. Ob das Schild gegen den Schlüssel ankommt, ist rechtlich offen. Ob Sie zustimmen, entscheidet nicht die IT, sondern die Geschäftsführung.
Der Start ist für den 20. November 2026 geplant und steht unter Vorbehalt. Stand: 1. November 2026.
Die Klausel gilt für jede geschäftliche Nutzung
Laut Vorschau der neuen Meta Commercial Terms, gleichlautend in den Self-Serve Ad Terms für Werbekunden, erlauben Unternehmen Meta, mit Crawlern Domains, Webseiten und Adressen zu durchsuchen, die «associated with your products or services» sind, also mit ihren Produkten oder Diensten verbunden. Meta darf dafür Testzugänge anlegen und regelmäßig Aktualisierungen abrufen.
Das gilt von Werbung bis zur Verwaltungssoftware Meta Business Suite, unabhängig von der Rechtsform. Wer Facebook oder Instagram nur privat nutzt, fällt nicht darunter, eine Fotografin mit Geschäftsprofil dagegen schon. Unternehmen sichern außerdem zu, alle Rechte zu besitzen, die sie Meta einräumen. Einschätzung der Redaktion: Heikel ist das bei Inhalten mit eingeschränkten Nutzungsrechten, etwa Stockfotos.
Der Starttermin am 20. November 2026 steht unter Vorbehalt
Geplant war der 30. Oktober 2026. Nach Protesten strich Meta am 16. Oktober das Wort «train» (trainieren), am 23. Oktober verschob Meta laut Nieman Lab den Start auf den 20. November 2026. Am 28. Oktober schrieb Metas Kommunikationsvize Andy Stone auf X, Meta wolle die Regeln nicht ohne «a full consultation», eine umfassende Konsultation, mit Branchenverbänden ändern. Dauere sie über den 20. November hinaus, verschiebe Meta erneut. Bis dahin gelten die bisherigen Bedingungen.
Auch Gerichte und Behörden sind eingeschaltet:
Norwegen: Das Bezirksgericht Oslo untersagte Meta laut dem Rundfunk NRK am 28. Oktober auf Antrag norwegischer Medienhäuser vorläufig, die Änderungen einzuführen. Unternehmen in Deutschland, Österreich oder der Schweiz schützt das nicht unmittelbar. Den Beschluss hat die Redaktion nicht eingesehen.
Großbritannien: Die Wettbewerbsbehörde CMACompetition and Markets Authority, die britische Wettbewerbsbehörde. Sie prüft seit 30. Oktober 2026 in einem förmlichen Verfahren, ob Meta mit den neuen Bedingungen eine marktbeherrschende Stellung im Vereinigten Königreich missbraucht. prüft seit 30. Oktober in einem förmlichen Verfahren, ob Meta im Vereinigten Königreich marktbeherrschend ist und britischen Unternehmen unfaire Konditionen auferlegt. Entschieden ist noch nichts, den Start nennt die CMA «put on hold», also ausgesetzt.
EU: Die Verbände der deutschen Zeitungs- und Zeitschriftenverlage fordern die EU-Kommission auf, die Klausel zu stoppen. Ein förmliches Verfahren der Kommission ist nicht bekannt.
Die Streichung von «train» begrenzt den Wortlaut, nicht das Crawling
Was gestrichen wurde: Im von Nieman Lab zitierten Originaltext stand noch «train» (trainieren). Die geänderte Vorschau nennt nur noch Werbe- und Geschäftsprodukte sowie die Integrität und Sicherheit der Meta-Produkte. Was Meta sagt: Stone schrieb am 17. Oktober auf X, die Änderungen gäben Meta keine «new rights to supersede such preferences», also keine neuen Rechte, Wünsche in der robots.txt zu übergehen.
Was offen bleibt: Eine Sprecheraussage ist keine vertragliche Zusage, und der Vertragstext erwähnt robots.txt nicht. Der Anwalt Matt Topic hält es laut Nieman Lab für möglich, dass «develop» (entwickeln) auch Training umfasst. Ob ein Vorbehalt gegen automatisiertes Auswerten (Text- und Data-MiningAutomatisiertes Auswerten großer Mengen von Texten, Bildern oder Daten, etwa für KI-Training. Rechteinhaber können in der EU einen Vorbehalt erklären, bei Online-Inhalten maschinenlesbar, in Deutschland nach § 44b Urheberrechtsgesetz.) per robots.txt, also das Schild, die vertragliche Erlaubnis einschränkt oder der Vertrag vorgeht, ist nicht geklärt.
Mit der robots.txt lassen sich die meisten Meta-Crawler einzeln ansprechen
Laut Metas Crawler-Seite (Stand 21. Mai 2026) dient meta-externalagent unter anderem dem Training von KI-Grundmodellen, meta-externalads der Verbesserung von Werbung und anderen geschäftlichen Produkten. Dass meta-externalads zum Zweck der neuen Klausel passt, ist eine Ableitung der Redaktion.
Für Ihre IT: So sieht der Eintrag aus
# Meta: Training von KI-Modellen ablehnen
User-AgentDie Kennung, mit der sich ein Programm wie ein Crawler beim Abruf einer Website ausweist. In der robots.txt richten sich Regeln an diese Kennung.: meta-externalagent
Disallow: /

# Meta: Nutzung für Werbe- und Geschäftsprodukte ablehnen
User-Agent: meta-externalads
Disallow: /
Fügen Sie die Gruppen in die bestehende Datei ein, statt sie zu ersetzen. Ergänzen Sie keine Gruppe für alle Crawler (User-Agent: *) mit Allow: /, sie hob in unserem Test mit dem Prüfprogramm Protego eine bestehende Sperre aller Crawler auf. Änderungen greifen laut Meta nach bis zu 24 Stunden. Ob Werbefunktionen leiden, wenn meta-externalads gesperrt ist, dokumentiert Meta nicht.
Diese fünf Schritte sollten Sie jetzt veranlassen
Klären Sie, wer den Schlüssel herausgeben darf. Erfassen Sie alle Seiten, Profile, Werbekonten und Kataloge, auch die von Agenturen in Ihrem Namen. Agenturen sichern Meta zu, ihre Auftraggeber binden zu dürfen. Legen Sie fest, wer Meta-Bedingungen für Sie akzeptiert.
Prüfen Sie, wohin der Schlüssel passt. Listen Sie verknüpfte Domains auf und markieren Sie Inhalte mit Lizenzwert, mit eingeschränkten Rechten und hinter einem Login. Ob Sie für dabei erfasste personenbezogene Daten nach der Datenschutz-Grundverordnung mitverantwortlich sind, ist ungeklärt und ein Prüfpunkt für Ihre Datenschutzbeauftragten.
Lassen Sie das Schild aufhängen. Ihre IT ergänzt die robots.txt wie oben.
Halten Sie fest, wann welches Schild hing. Sichern Sie robots.txt und Vertragsfassung bei jeder Änderung mit Datum. Vor Gericht kann es darauf ankommen, welche Sperre wann galt.
Lassen Sie die Rechtslage prüfen. In der EU dürfen Online-Inhalte automatisiert ausgewertet werden, außer der Rechteinhaber hat es sich vorbehalten, in Deutschland nach § 44b des Urheberrechtsgesetzes maschinenlesbar. Über einen Fall zur Maschinenlesbarkeit will der Bundesgerichtshof am 17. Dezember 2026 entscheiden (I ZR 281/25). Ob Ihr Vorbehalt nach der Zustimmung gegenüber Meta greift und welches Recht bei Streit gilt, sollten Sie anwaltlich klären lassen. In Österreich gilt mit § 42h Absatz 6 Urheberrechtsgesetz eine entsprechende Regel, für die Schweiz eigenes Recht.
Den neuen Schlüssel gibt nur, wer zustimmt. Das Schild hängt nur, wer es aufhängt. Beides ist eine Entscheidung der Geschäftsführung.
Wir aktualisieren den Artikel, sobald Meta einen neuen Termin oder eine neue Fassung veröffentlicht.
Weiterlesen
Häufige Fragen
Wen betreffen die neuen Meta-Geschäftsbedingungen?
Alle, die Meta-Produkte geschäftlich nutzen: Werbekonten, Produktkataloge, Unternehmensseiten, Gruppen zu Geschäftszwecken und Werkzeuge wie Meta Business Suite. Entscheidend ist laut Vertragstext der geschäftliche Zweck, nicht die Kontoart. Betroffen sind damit auch Selbstständige mit Geschäftsprofil. Wer Facebook oder Instagram nur privat nutzt, fällt nicht darunter.
Ab wann gelten die neuen Bedingungen?
Die Vorschau bei Meta nennt den 20. November 2026 (Stand 1. November 2026). Ursprünglich war der 30. Oktober 2026 geplant. Am 28. Oktober 2026 kündigte Meta an, nach Gesprächen mit Branchenverbänden notfalls weiter zu verschieben. Bis dahin gelten die bisherigen Bedingungen. Die britische Wettbewerbsbehörde CMA bezeichnet den Start als «put on hold», also ausgesetzt.
Darf Meta Inhalte meiner Website für KI-Training verwenden?
Die neue Fassung nennt Training nicht mehr und begrenzt den Zweck auf Werbe- und Geschäftsprodukte. Rechtsexperten halten «develop» (entwickeln) aber für weit genug, um Training einzuschließen. Unabhängig davon nutzt Meta laut eigener Crawler-Seite Inhalte, die der Crawler meta-externalagent abruft, unter anderem für das Training von KI-Modellen. Ihn können Betreiber per robots.txt ausschließen.
Schützt eine robots.txt vor dem Crawling durch Meta?
Meta-Sprecher haben öffentlich erklärt, dass Websitebetreiber Meta-Crawler weiterhin per robots.txt ausschließen können. Eine öffentliche Sprecheraussage ist aber keine vertragliche Zusage, im Vertragstext steht das nicht. Laut Metas Crawler-Seite können facebookexternalhit bei Sicherheitsprüfungen und meta-externalfetcher bei Abrufen auf Nutzerwunsch robots.txt umgehen. Rechtlich kann die robots.txt in der EU als maschinenlesbarer Vorbehalt gegen Text- und Data-Mining zählen. Ob das gilt, wenn Sie Meta per Vertrag das Crawling erlaubt haben, ist offen.
Welche Meta-Crawler sollte ich sperren?
Das hängt vom Ziel ab. Gegen KI-Training hilft laut Metas Angaben eine Regel für meta-externalagent, gegen die Nutzung für Werbe- und Geschäftsprodukte eine für meta-externalads. Wer facebookexternalhit sperrt, muss mit Links ohne Vorschau rechnen. meta-webindexer hilft laut Meta, Inhalte in Antworten von Meta AI, Metas KI-Assistent, zu zitieren und zu verlinken.
Kann ich den neuen Bedingungen widersprechen?
Eine Möglichkeit, der Crawling-Klausel zu widersprechen, nennt der Vertragstext nicht. Wer Meta-Produkte nach der Ankündigung weiter geschäftlich nutzt, stimmt laut Vertragstext zu, wer nicht zustimmt, kann die geschäftliche Nutzung beenden. Bei Streit mit Meta Platforms Ireland gelten laut Vertrag, wie schon in der geltenden Fassung, irisches Recht und irische Gerichte, bei Streit mit dem US-Konzern Meta Platforms, Inc. oder mit beiden kalifornisches Recht und Gerichte in Kalifornien. Rechte aus dem EU-Gesetz über digitale Märkte (DMA) sollen laut Vertrag unberührt bleiben. Welche Gesellschaft Ihr Vertragspartner ist und ob die Klauseln wirksam sind, sollten Sie anwaltlich klären lassen.
Fügen Sie KI-Amigo in Google als bevorzugte Quelle hinzu, um unsere Artikel häufiger zu sehen.
Weiterlesen
Mehr aus Recht & Regulierung →
Landgericht Köln: Snapchat darf Chatbot-Daten nicht ohne Rechtsgrundlage für Werbung nutzen
Das Landgericht Köln beanstandet Snapchats Werbenutzung von Chatbot-Daten ohne Rechtsgrundlage sowie bestimmte Voreinstellungen. Das Urteil betrifft die konkret geprüfte Gestaltung und ist laut vzbv noch nicht rechtskräftig.
Schatten-KI im Recruiting: So regeln Arbeitgeber die KI-Vorauswahl von Bewerbungen
35 Prozent der befragten Personalverantwortlichen haben für die erste Sichtung einer Bewerbung höchstens eine Minute. 28 Prozent berichten, dass Beschäftigte ohne offizielle Lösung mit Werkzeugen wie ChatGPT vorsortieren. Was Datenschutzrecht und AI Act dazu sagen und wer am Ende prüft.
Dossiers ohne Einwilligung: Meta Muse erfasst Verwandte und Freunde
Muse kann auch Daten über Nichtnutzer verarbeiten. Wir trennen dokumentierte Anweisungen von belegtem Verhalten und erklären Löschmöglichkeiten sowie offene Datenschutzfragen.
KI-Haftpflichtversicherung: Versicherer entwickeln eigene Deckungen
Eigene KI-Haftpflichtprodukte existieren bereits. Wie Unternehmen Fallzahlen, Versicherungsversprechen und den Schutz ihrer konkreten Anwendungen einordnen.

McDonald’s wegen KI-gestützter Preisempfehlungen verklagt
Eine US-Klage wirft McDonald’s wettbewerbswidrige Preisempfehlungen durch Software vor. Der Konzern widerspricht. Was behauptet wird und welche Fragen zur tatsächlichen Nutzung des Systems offenbleiben.
US-Gericht pausiert das Verbot für KI-Nacktbilder wegen Bedenken zur Meinungsfreiheit
Der 8. US-Berufungsgerichtshof hat ein Gesetz des Bundesstaates Minnesota gegen synthetische Nacktdarstellungen vorläufig außer Kraft gesetzt. Die Richter gaben damit einem Eilantrag des Entwicklers xAI statt. Das Unternehmen sieht durch das Verbot die Meinungsfreiheit eingeschränkt.